
Comment devenir analyste de données dans le football : en quoi consiste vraiment le métier
Les analystes de données dans le football travaillent sur le recrutement, le scouting et la performance, en transformant de grands volumes de données en informations réellement utiles à la prise de décision. Voici ce que recouvre le métier et ce qu'il faut pour y entrer.
Cet article a été rédigé à l’origine en English . La traduction que vous lisez actuellement peut contenir des erreurs éditoriales.
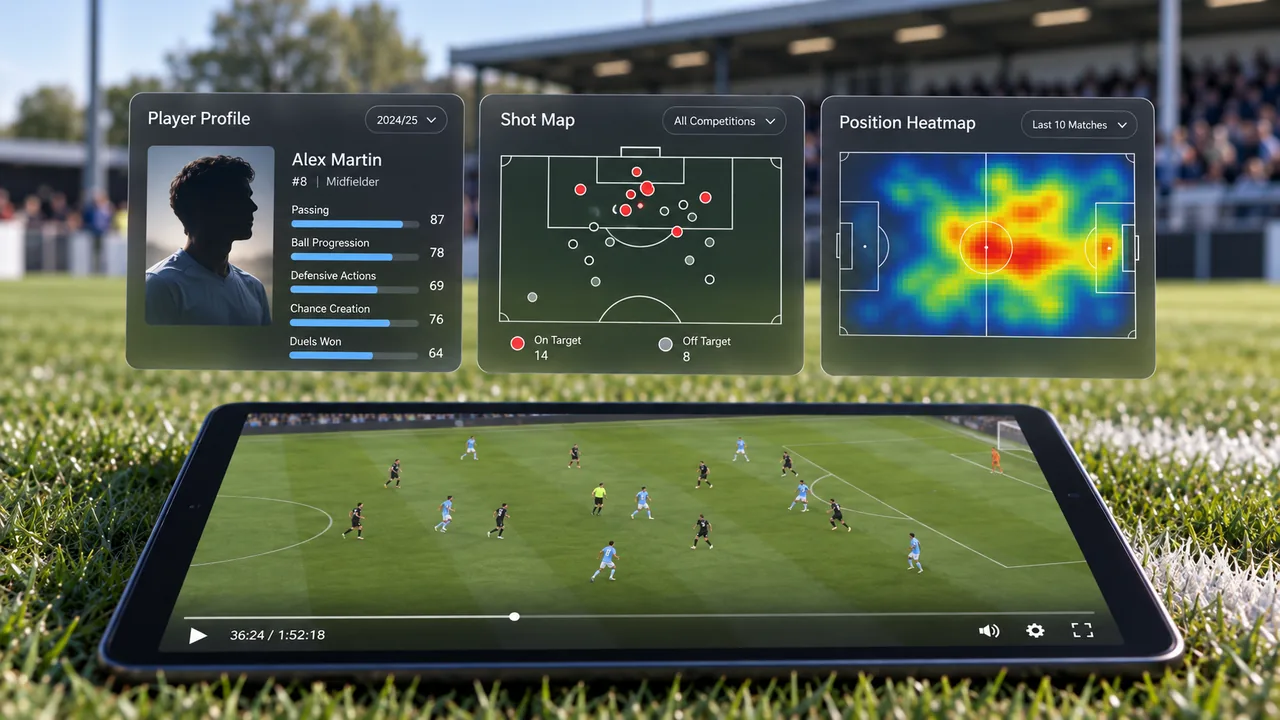
Le football n’a jamais manqué de chiffres. Buts, passes décisives, tirs, possession et pourcentages de passes font partie du jeu depuis des décennies. Ce qui a changé, c’est la quantité d’informations désormais disponibles pour les clubs, et la place qu’elles occupent dans le recrutement, la performance, la planification d’effectif et les décisions du staff.
Un match professionnel peut produire des milliers d’actions enregistrées. Selon les outils dont dispose un club, les analystes peuvent également étudier la position de chaque joueur, sa vitesse de déplacement, les lignes de passe disponibles, la compacité d’un bloc défensif, le moment où un pressing commence à être dépassé ou encore ce qui se passe sans ballon avant la création d’une occasion. À cela s’ajoutent plusieurs saisons de données individuelles, de vidéo, de rapports de scouting, d’informations d’entraînement et de tests physiques. Le volume devient vite bien trop important pour être traité correctement par un entraîneur ou un scout seul.
Le rôle de l’analyste de données football est de transformer cet ensemble en quelque chose d’exploitable. Cela peut vouloir dire chercher des joueurs correspondant à un profil de recrutement, comprendre pourquoi une équipe crée moins de bonnes occasions, comparer les exigences physiques de différentes compétitions ou vérifier si un schéma repéré à la vidéo revient suffisamment souvent pour être significatif.
Le quotidien du métier est généralement moins spectaculaire que l’image publique de la data dans le football. Un analyste ne passe pas ses journées à découvrir des pépites sous-évaluées ou à construire des modèles qui décident à la place du club qui recruter. Une grande partie du travail consiste à poser une bonne question, identifier les données susceptibles d’y répondre, vérifier leur qualité et être clair sur ce qu’elles permettent réellement de conclure.
Que fait vraiment un analyste de données football ?
Il n’existe pas une seule version du poste. Un analyste peut travailler au recrutement, avec l’équipe première, dans les sciences du sport, au centre de formation ou au sein d’un département plus large consacré à la stratégie football. Dans les grands clubs, ces domaines peuvent être répartis entre plusieurs analystes, data scientists et data engineers. Dans des structures plus petites, une seule personne peut couvrir une partie de plusieurs fonctions.
Un analyste orienté recrutement peut passer une grande partie de sa semaine à comparer des joueurs entre plusieurs championnats, maintenir des outils de recherche, étudier des remplaçants potentiels pour un joueur de l’effectif ou aider les scouts à décider quels profils méritent une observation plus poussée. Quelqu’un de plus proche de l’équipe première peut travailler sur la création d’occasions, la relance, le pressing, les transitions défensives ou le prochain adversaire. Un profil rattaché aux sciences du sport s’intéressera davantage aux données GPS, aux charges de sprint et aux exigences physiques imposées aux joueurs.
C’est aussi pour cela que les intitulés peuvent être trompeurs. Deux clubs peuvent publier une offre de “Football Data Analyst” tout en recherchant des profils assez différents. L’un peut donner beaucoup d’importance à Python et SQL. Un autre peut chercher un mélange d’analyse vidéo, de dashboards et de soutien au recrutement. Dans un troisième club, le même titre peut être beaucoup plus proche de la performance physique. Pour comprendre une offre, les responsabilités décrites comptent souvent davantage que l’intitulé.
Une bonne analyse commence souvent avant d’ouvrir un notebook ou d’écrire une requête. Elle commence par le problème football.
Imaginons qu’un club cherche un arrière gauche. Le besoin paraît simple jusqu’au moment où il faut définir le rôle. Doit-il rester large et attaquer le couloir ? Rentrer à l’intérieur lorsque l’équipe a le ballon ? Défendre de grands espaces derrière un pressing haut ? Conduire sous pression ? Multiplier les dédoublements ? Pouvoir jouer piston également ? La vitesse de repli est-elle plus importante que la qualité de centre ?
Ces décisions déterminent ce qu’il faut mesurer. Si le profil est mal défini, ajouter davantage de données ne fait souvent que produire une version plus complexe de la même question imprécise.
Une fois le rôle clarifié, le travail devient plus technique. Il peut être nécessaire de nettoyer et de fusionner des données provenant de plusieurs fournisseurs. Le niveau des championnats doit parfois être pris en compte. Le temps de jeu, la possession de l’équipe ou le style peuvent fausser des comparaisons brutes. Parfois, un modèle est construit ; dans d’autres cas, la réponse vient d’un travail statistique assez simple, de nombreuses vérifications et du temps consacré à s’assurer que la comparaison est réellement pertinente.
La dernière étape consiste à communiquer le résultat. Les entraîneurs et les scouts n’ont pas besoin de lire le code qui se trouve derrière l’analyse. Ils doivent comprendre ce qui a été trouvé, quel niveau de confiance accorder au résultat et ce qu’il faut regarder ensuite. Parfois, cela passe par un dashboard. Parfois, un court rapport suffit. Dans certains cas, la sortie la plus utile tient à un seul graphique et quelques minutes de discussion.
Les données utilisées dans le football moderne
“Données de football” ne désigne pas une seule chose. Le type le plus connu est celui des données événementielles, qui enregistrent les actions d’un match : passes, tirs, conduites, tacles, interceptions, pressings, duels, fautes et autres événements. Ces enregistrements peuvent inclure l’endroit où l’action a eu lieu, la destination du ballon, sa réussite ou non et d’autres informations liées à la situation.
Une grande partie de l’analytique devenue familière aujourd’hui repose sur ce type de données. Expected goals (xG), expected assists (xA), passes progressives, conduites progressives, cartes de tirs, réseaux de passes ou entrées dans la surface en dépendent directement.
Mais les données événementielles ne racontent qu’une partie du match. Un attaquant peut emmener deux défenseurs avec lui grâce à un appel et créer de l’espace pour un partenaire sans toucher le ballon. Un milieu peut fermer une ligne de passe pendant plusieurs secondes sans enregistrer la moindre action défensive. Un défenseur central peut choisir de ne pas jouer vers l’intérieur parce que le receveur est bien pris ; la bonne décision est précisément de ne pas tenter cette passe.
Une grande partie du football se déroule entre les événements enregistrés.
Les données de tracking apportent une couche supplémentaire en enregistrant de manière répétée la position des joueurs et du ballon pendant le match. Elles permettent d’étudier la largeur d’une équipe, la hauteur de la ligne défensive, les déplacements sans ballon, les distances entre joueurs, les structures de pressing et les options disponibles pour le porteur. On ne regarde plus seulement si une passe a été réussie, mais aussi sa difficulté, la pression subie par le joueur et les autres solutions disponibles.
Il existe aussi les données physiques. Distance totale, course à haute intensité, distance parcourue en sprint, vitesse maximale, accélérations et décélérations permettent de mieux comprendre les exigences d’un rôle. Elles sont importantes pour la performance, mais également pour le recrutement. Un joueur peut correspondre techniquement à une équipe tout en ne possédant pas le profil physique exigé par le poste auquel il est destiné.
À l’intérieur d’un club, les sources peuvent être encore plus larges. Les analystes peuvent travailler avec des données GPS, des charges d’entraînement, des informations médicales et de disponibilité, des notes de scouting, des évaluations de jeunes, des données contractuelles et des observations internes accumulées sur plusieurs saisons.
La difficulté n’est pas d’utiliser tout ce qui existe. Elle consiste à déterminer quelle partie de ces informations aide vraiment à répondre à la question posée.
Pourquoi le contexte compte plus qu’une longue liste de métriques
Il ne faut pas longtemps pour apprendre le vocabulaire de base de l’analytique football. xG, xA, PPDA, field tilt, possession value, passes progressives et des dizaines de métriques propres à chaque fournisseur sont faciles à trouver. Le plus difficile est d’apprendre quand un chiffre apporte réellement quelque chose et quand le contexte explique presque tout.
L’expected goals en est un bon exemple. Un modèle de xG estime la probabilité qu’un tir devienne un but à partir d’éléments comme sa position, son angle et, selon le modèle, d’autres détails de la situation. Les fournisseurs construisent leurs modèles différemment, ce qui signifie qu’un même tir peut recevoir des valeurs légèrement différentes.
L’intérêt du xG n’est pas d’attribuer un chiffre décimal à chaque tentative. Il sert à distinguer la qualité des occasions du résultat obtenu.
Deux attaquants peuvent terminer une saison avec 15 buts. Le premier peut se créer chaque semaine d’excellentes positions et finir à un niveau normal. Le second peut avoir marqué plusieurs tirs très difficiles à partir d’un ensemble d’occasions beaucoup moins favorable. La colonne des buts indique 15 pour les deux. Ce qui se trouve derrière ces chiffres peut être très différent.
Le même problème existe avec des statistiques plus simples. Un défenseur central à 94 % de passes réussies peut être excellent pour faire progresser le ballon, ou passer l’essentiel du match à jouer court et sans risque. Un ailier avec beaucoup de conduites progressives peut être exceptionnel en un contre un, ou simplement évoluer dans une équipe de transition qui lui laisse régulièrement de l’espace. Un milieu avec de très gros chiffres défensifs peut être dominant sans ballon, ou jouer dans une équipe qui passe une grande partie de ses matches à défendre.
Les données par 90 minutes corrigent le temps de jeu, mais elles ne règlent pas automatiquement le problème de comparaison. La possession compte. Le score compte. Le rôle compte. Le niveau de l’équipe compte. Les consignes de l’entraîneur comptent. Le championnat compte.
Le travail récent de recrutement de Manchester City offre un bon exemple. En septembre 2026, un reportage sur le processus du club a montré que City ne considère pas tous les arrières latéraux comme un seul type de joueur. Le club distingue plusieurs profils, notamment des latéraux plus défensifs, des joueurs qui rentrent à l’intérieur et des latéraux qui évoluent plus haut et plus large. La distinction précède la comparaison chiffrée : on définit d’abord le rôle, puis on choisit les données adaptées pour l’évaluer. Le reportage de BBC Sport sur le processus de recrutement de Manchester City.
C’est beaucoup plus proche de l’analytique professionnelle que de mettre deux radars côte à côte et de décider lequel occupe la plus grande surface.
Comment les clubs utilisent les données dans le recrutement
Le recrutement est probablement le domaine où il est le plus facile de comprendre pourquoi les clubs emploient des analystes de données. Le problème de départ est immense. Aucun département de scouting ne peut observer en profondeur tous les joueurs professionnels de toutes les compétitions potentiellement intéressantes. Il faut donc décider où consacrer du temps.
Les données servent notamment à réduire cette recherche.
Le cas de Manchester City permet de voir l’échelle du problème. D’après le reportage publié en 2026 sur son fonctionnement, le club part d’une base d’environ 650 000 joueurs. Une fois le profil recherché défini, des filtres analytiques peuvent réduire ce nombre à une longlist d’environ 20 à 50 noms. Cette liste est ensuite croisée avec le travail des scouts et réduite à nouveau avant une étude plus poussée. BBC Sport.
Le chiffre attire l’attention, mais l’ordre du processus est plus important. Pour que les filtres aient du sens, quelqu’un doit d’abord définir le type de joueur recherché. Ensuite, les données ne prennent pas la décision finale. Hugo Viana, directeur sportif de City, rappelle dans le même reportage que l’information quantitative ne représente qu’une partie de l’évaluation, parce qu’elle ne peut pas décrire complètement des éléments comme le caractère, la mentalité ou le comportement.
Un autre exemple est apparu dans le documentaire du club A Beautiful Obsession. Lors du travail visant à trouver un joueur capable de reprendre une partie des responsabilités créatives de Kevin De Bruyne, les analystes de City expliquent avoir mesuré 43 métriques, les avoir réduites à sept valeurs et utilisé ces dimensions pour regrouper des profils similaires. Rayan Cherki apparaît alors comme un joueur pouvant, avec le temps, se rapprocher du profil de De Bruyne, avant d’être finalement recruté par City. Page officielle de Manchester City consacrée à A Beautiful Obsession.
L’intérêt de cet exemple n’est pas d’essayer de deviner le modèle exact utilisé par le club. Nous ne connaissons pas les 43 variables, leur pondération ni tous les détails de la méthode. Ce qu’il montre surtout, c’est le travail qui précède une recherche de similarité utile.
“Trouver le prochain Kevin De Bruyne” n’est pas une question exploitable telle quelle. Quelles parties de son jeu le club cherche-t-il à remplacer ? La création d’occasions ? Les passes vers le dernier tiers ? La progression du ballon ? Les conduites ? La menace au tir ? Les zones de réception ? La capacité à jouer sous pression ? Quel poids faut-il donner à chaque élément ?
Le rôle de l’analyste consiste en partie à transformer cette description football en critères mesurables. La shortlist vient ensuite.
C’est pourquoi il vaut mieux éviter d’imaginer l’analytique de recrutement comme un système automatisé de transferts. Son intérêt est souvent de réduire une recherche impossible à une liste de joueurs que les scouts et les responsables du recrutement peuvent réellement étudier en détail.
Performance, tactique et analyse de l’adversaire
Tous les analystes de données football ne travaillent pas sur les transferts. Certains passent l’essentiel de leur temps sur les problèmes rencontrés chaque semaine par l’équipe.
Imaginons une équipe qui commence à créer moins d’occasions. Les statistiques les plus évidentes peuvent montrer une baisse du nombre de tirs, mais elles n’expliquent pas pourquoi. L’analyste peut étudier la fréquence d’entrée dans le dernier tiers, les zones utilisées pour progresser, la pression subie par les milieux lors de la réception, la progression des latéraux ou un éventuel changement dans la façon dont les adversaires défendent la relance.
Un problème défensif peut demander des questions complètement différentes. À quelle fréquence la première ligne de pression est-elle dépassée ? Que se passe-t-il juste après ? Le milieu arrive-t-il trop tard sur les seconds ballons ? Les adversaires trouvent-ils toujours le même espace ? La ligne défensive joue-t-elle plus bas depuis plusieurs semaines ?
Ce type de travail est souvent plus fort lorsque les données et la vidéo sont utilisées ensemble. La vidéo peut suggérer qu’un schéma existe ; les données permettent de vérifier s’il se répète assez souvent pour mériter de l’attention. L’inverse fonctionne aussi : un chiffre inhabituel peut indiquer précisément ce qu’il faut chercher dans les images.
L’analyse de l’adversaire suit la même logique. Un staff technique gagne peu à recevoir toutes les statistiques disponibles sur le prochain adversaire. Les questions utiles sont plus précises. Comment construit-il depuis les six mètres ? Quel joueur devient important sous pression ? Préfère-t-il un côté pour sortir de son camp ? Où perd-il le plus souvent le ballon ? Quelles situations produisent ses meilleures occasions ?
Il existe ici un chevauchement évident avec l’analyse de performance. Traditionnellement, les performance analysts ont travaillé davantage avec la vidéo, le codage des matches et les présentations tactiques, tandis que les data analysts ont été plus proches des données structurées, des statistiques et des modèles. Dans les clubs modernes, la frontière est souvent beaucoup moins nette. Les deux profils doivent comprendre suffisamment le travail de l’autre pour collaborer correctement.
La partie technique du métier
Le sujet est le football, mais cela reste un métier de données.
SQL est important parce que les clubs et les entreprises spécialisées stockent de grandes quantités d’informations dans des bases de données. L’analyste doit savoir trouver les bons enregistrements, joindre des tables, filtrer les données et écrire des requêtes reproductibles sans reconstruire le même processus à la main chaque semaine.
Python est très courant en analytique football et en data science. R dispose également d’une communauté solide dans ce domaine. Les deux peuvent servir à nettoyer les données, automatiser des tâches, réaliser des analyses statistiques, construire des modèles et créer des visualisations. Empiler les langages de programmation sur un CV apporte peu ; savoir utiliser correctement l’un d’eux sur des données réelles et imparfaites est beaucoup plus utile.
Excel reste présent également. Les vérifications rapides, les listes de scouting et les demandes ponctuelles passent encore souvent par des feuilles de calcul. Power BI et Tableau sont courants lorsqu’un club souhaite des dashboards que les entraîneurs, scouts ou dirigeants peuvent utiliser sans toucher au code.
Une partie importante du travail est beaucoup moins élégante que le graphique final. Il faut faire correspondre les noms de joueurs entre plusieurs fournisseurs. Les compétitions changent de nom. Certains enregistrements manquent. Un fournisseur modifie un champ et une requête qui fonctionnait la veille tombe en panne. Des doublons apparaissent. Quelqu’un découvre qu’un dashboard utilise le mauvais filtre depuis une semaine.
Ce sont des problèmes de données ordinaires. Le football les connaît aussi.
Les statistiques sont importantes pour la même raison. Un analyste doit être à l’aise avec les moyennes, distributions, variances, percentiles, probabilités, corrélations, tailles d’échantillon et incertitudes. Le football produit constamment de petits échantillons et des résultats très bruyants. Un joueur peut connaître six semaines exceptionnelles qui disent peu de choses sur les deux années suivantes. Une équipe peut bien jouer et perdre. Une métrique sous-jacente peut être utile sans représenter parfaitement la réalité.
Les travaux plus avancés peuvent inclure régression, classification, clustering, réduction de dimension ou machine learning. La vision par ordinateur a également élargi le champ en permettant d’extraire des informations de position à partir de la vidéo.
Rien de tout cela ne rend automatiquement une méthode complexe meilleure. Une analyse simple qui répond clairement à la question est plus utile qu’un modèle avancé construit uniquement pour utiliser une technique sophistiquée.
Quelle connaissance du football faut-il avoir ?
Assez pour reconnaître quand les données passent à côté du sujet.
Il n’est pas nécessaire d’avoir joué au niveau professionnel ni d’avoir été entraîneur, mais il est difficile d’interpréter correctement les données sans comprendre le jeu. Le contexte tactique change les chiffres en permanence. Les statistiques d’un ailier peuvent progresser parce que son rôle a changé, pas parce qu’il est devenu meilleur. Un milieu peut sembler moins progressif après avoir rejoint une équipe plus forte parce qu’un autre joueur prend désormais en charge la progression du ballon. Un défenseur central peut enregistrer moins d’actions défensives simplement parce que son équipe domine davantage la possession.
Les chiffres n’expliquent pas ces différences seuls.
L’inverse est également vrai. On peut très bien comprendre le football tout en manquant des compétences techniques ou statistiques nécessaires au travail de données. La connaissance tactique n’enseigne pas SQL. Avoir regardé des milliers de matches ne rend pas automatiquement à l’aise avec les probabilités, les échantillons ou le nettoyage de données.
On peut entrer dans le métier des deux côtés. Certains viennent du football et construisent ensuite la partie technique. D’autres arrivent des mathématiques, de l’informatique, de l’ingénierie, de l’économie, de la finance ou d’autres secteurs très orientés données et doivent développer leur compréhension du jeu.
Pour quelqu’un venant de l’extérieur du football, regarder les matches en parallèle du travail sur les données est l’une des habitudes les plus utiles. Si un joueur paraît inhabituel dans les chiffres, regardez-le. Si deux joueurs semblent presque identiques statistiquement, regardez les deux et trouvez où la similitude disparaît. Si une métrique change fortement après un transfert ou un changement d’entraîneur, revenez aux matches.
Avec le temps, on commence à voir quelles parties du jeu sont bien captées par les données et lesquelles demandent davantage de prudence.
Faut-il un diplôme, et comment commencer ?
Il n’existe pas un seul parcours académique pour devenir analyste de données football. Les études en statistiques, mathématiques, informatique, data science, ingénierie ou économie peuvent fournir de bonnes bases. Des profils issus des sciences du sport ou de l’analyse de performance accèdent également à ces postes lorsqu’ils ajoutent programmation et statistiques à leur connaissance du football.
Certains employeurs demandent explicitement un diplôme pertinent. D’autres regardent surtout ce que la personne sait faire en pratique. Pouvez-vous travailler avec un grand dataset ? Écrire du code propre et reproductible ? Comprendre réellement les concepts statistiques de base ? Expliquer pourquoi vous avez choisi une métrique ? Votre analyse tient-elle encore lorsque quelqu’un regarde le match ?
Les postes de data science plus orientés recherche peuvent accorder davantage d’importance aux études supérieures, mais l’analytique football n’a pas une seule voie académique.
C’est aussi l’un des rares domaines du football professionnel où il est possible de produire un travail crédible avant d’avoir accès aux systèmes internes d’un club. Les datasets publics le permettent. Hudl Statsbomb, par exemple, publie des données événementielles ouvertes pour plusieurs compétitions et met à disposition des ressources pour les exploiter avec Python et R. StatsBomb Open Data.
Un portfolio n’a pas besoin d’être énorme. Un seul projet bien conçu peut en dire beaucoup plus que dix radars de joueurs presque identiques.
Mieux vaut commencer par une question de football que par une visualisation. Quels milieux font progresser le ballon d’une certaine manière ? La création d’occasions d’une équipe a-t-elle changé après un changement d’entraîneur ? Quels attaquants arrivent régulièrement dans des positions de tir de grande qualité ? Comment chercheriez-vous des joueurs pour un rôle tactique très précis ?
Il faut ensuite montrer le raisonnement. Expliquer pourquoi la question a été choisie, ce que couvrent les données et ce qu’elles laissent de côté, pourquoi certaines métriques ont été retenues et comment les résultats surprenants ont été vérifiés. Lorsque c’est possible, revenir à la vidéo. Si l’analyse présente des limites, il faut les mentionner.
Cela ressemble beaucoup plus au type de travail qu’un club attend que de simplement produire un graphique propre.
Publier ses travaux peut également aider. Un site personnel, un dépôt GitHub ou une analyse bien écrite donnent à un recruteur quelque chose de concret à examiner. Ils donnent aussi aux personnes du secteur une base réelle de discussion. Savoir utiliser Python est utile ; montrer comment on s’en sert pour réfléchir à un problème football en dit davantage.
À quoi ressemble réellement le travail au quotidien ?
Toutes les semaines ne sont pas consacrées à chercher la prochaine recrue.
Il y a du nettoyage de données, des demandes urgentes, des dashboards à modifier, des requêtes qui cessent de fonctionner et des analyses qui ne débouchent sur rien. On peut passer des heures sur un schéma intéressant avant de découvrir qu’il disparaît après la correction d’une seule erreur de données. Parfois, après plusieurs heures de travail, la conclusion est simplement qu’il n’existe pas assez d’éléments pour affirmer quelque chose avec confiance.
C’est aussi un résultat utile.
Les décisions liées au travail peuvent néanmoins être importantes. Une analyse de recrutement peut alimenter une discussion autour d’un transfert à plusieurs millions. Un rapport destiné à l’équipe première peut arriver au staff peu avant un match. Une erreur non repérée peut rester dans le système assez longtemps pour influencer une discussion qu’elle n’aurait jamais dû atteindre.
Les horaires dépendent beaucoup de l’endroit où se situe le poste. Les rôles proches de l’équipe première peuvent inclure des soirées, des week-ends et des jours de match. Les départements de recrutement connaissent des périodes plus intenses autour des marchés des transferts. Les emplois chez les fournisseurs de données ou dans les entreprises de technologie sportive peuvent ressembler davantage à des postes techniques classiques.
Les salaires varient fortement eux aussi. Une personne maîtrisant bien SQL, Python et les statistiques peut gagner nettement plus dans la finance, la technologie ou une autre industrie commerciale. Le football attire énormément de candidats et n’est pas toujours le secteur qui rémunère le mieux ce type de compétences.
L’intérêt se trouve ailleurs. Le travail peut être très proche des décisions réelles du football. Une analyse peut changer le prochain joueur qu’un scout décide d’observer, remettre en question une idée installée au sein du recrutement ou aider un staff à mieux comprendre quelque chose qu’il voit sur le terrain depuis plusieurs semaines.
Les compétences restent aussi utiles hors du football. SQL, Python, statistiques, visualisation et data engineering conservent leur valeur si le prochain poste se trouve dans un autre club, une fédération, un fournisseur de données, une entreprise de technologie sportive ou dans un tout autre secteur.
Avec l’expérience, un bon analyste apprend également ce qu’il ne faut pas analyser. Il sait quand deux joueurs ne doivent pas être comparés directement, quand un échantillon est trop faible et quand une métrique décrit davantage l’équipe que le joueur. Il vérifie les résultats qui paraissent trop propres. Si les éléments sont faibles, il le dit.
Les clubs modernes peuvent collecter beaucoup plus d’informations que nécessaire pour une seule décision. Le travail ne consiste pas à tout mettre dans la réponse, mais à déterminer ce qui mérite réellement d’y figurer.
Le processus de recrutement de Manchester City l’illustre bien précisément parce que les données ne ferment pas le dossier. Des centaines de milliers de joueurs peuvent être réduits à une liste exploitable. Des modèles peuvent signaler des profils qui méritent d’être étudiés. Le tracking et les données physiques peuvent mettre en évidence des qualités difficiles à comparer de façon constante à l’œil nu.
Mais les joueurs de cette liste doivent encore être observés. Les scouts doivent se faire une opinion. Les entraîneurs doivent décider s’ils correspondent au projet. Les questions médicales, contractuelles et financières doivent toujours être traitées.
C’est là que le rôle de l’analyste prend tout son sens : non pas décider à la place des autres, mais faire en sorte que ceux qui décident disposent de meilleures informations.


